AI吃坏了肚子:互联网被垃圾信息污染,硅谷巨头开始扫荡旧书店
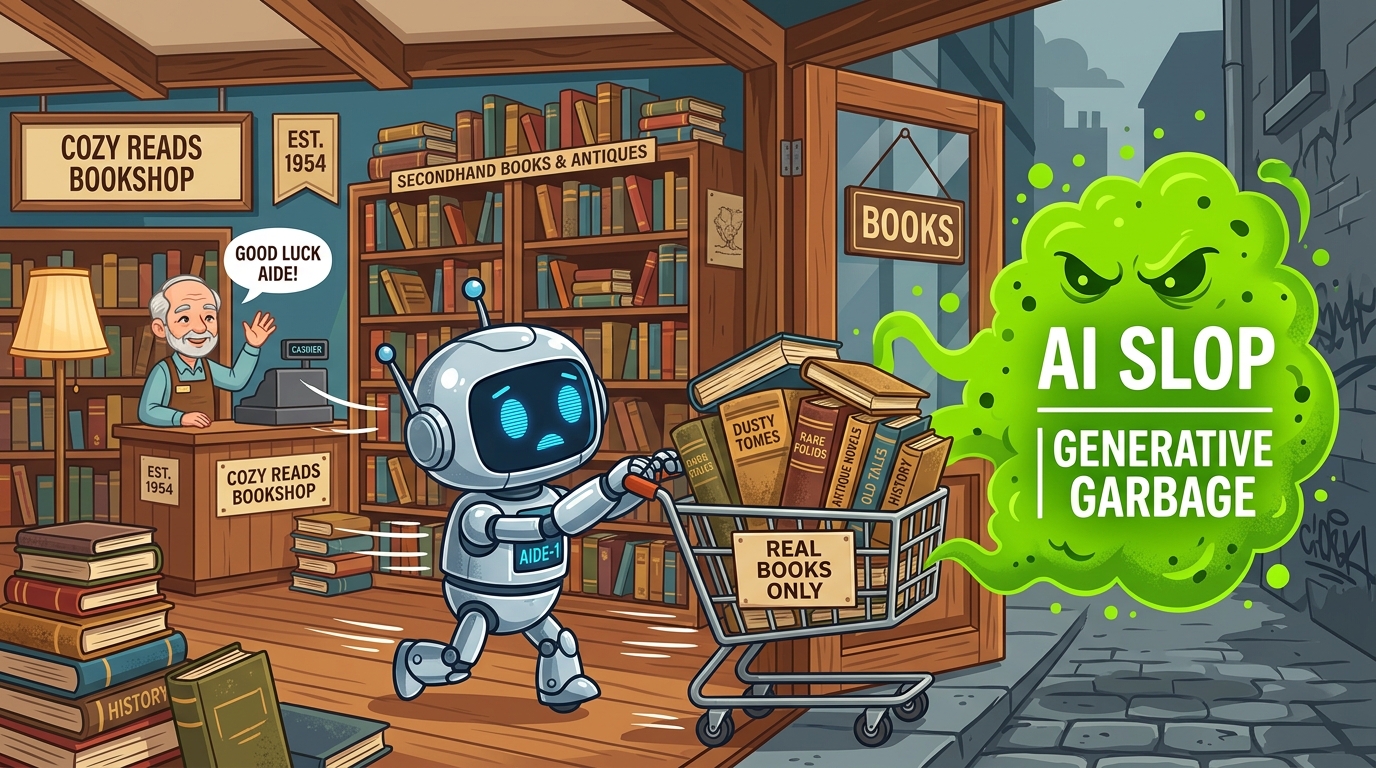
硅谷花了二十年告诉全世界:纸质书是早该被淘汰的过时遗物。而今天,正是这群科技巨头在各地的二手书店里发了疯似地抢购1978年的家电维修指南,只为了搞清楚真正的人类到底是怎么说话的。
近期,英国、爱尔兰及北美等地的众多二手书店店主都遇到了一件怪事:神秘买家突然以极高频率大批量清空书架。这些订单既不是文学教授在做研究,也不是书痴在收藏古董,书单混乱得匪夷所思——从80年代的拖拉机维修手册、19世纪偏门地方诗集,到停印的社会学教材和发黄的园艺小册子。
📚 AI吃自己的排泄物:模型崩溃危机
为什么AI实验室对泛黄的纸张如此饥渴?因为互联网已经被它们自己的产物彻底污染了。过去几年里,生成式AI制造了数以万亿计的廉价SEO垃圾、充满幻觉的博客和合成废话——这种现象被学者称为“模型崩溃(Model Collapse)”。用现在的互联网训练新AI,就像给牛喂牛肉汉堡一样,会导致严重的数字“疯牛病”。
为了训练下一代前沿基础大模型,科技巨头必须找到“处女地数据”——即严格写于2022年之前、百分之百由有心跳和灵魂的碳基人类写下的文字。而如今地球上最纯净、未被AI污染的语料库在哪?就在二手书店角落里落满灰尘的纸箱中。
✂️ 工业断头台:破坏性扫描
这些被买走的旧书命运相当惨烈。数据采集机构通常采取“破坏性扫描”:用工业切纸刀直接切掉书脊,以每分钟200页的超高速送入扫描仪进行OCR识别,随后将粉碎的纸张直接送去打浆再造。
这可以说是科技史上最极致的讽刺。人工智能本该数字化人类思维并让我们彻底摆脱物理束缚,结果它却把互联网给搞瘫了,以至于价值万亿的智能算法现在不得不靠着奶奶1974年的酸种面包食谱来维持理智。
猜你喜欢
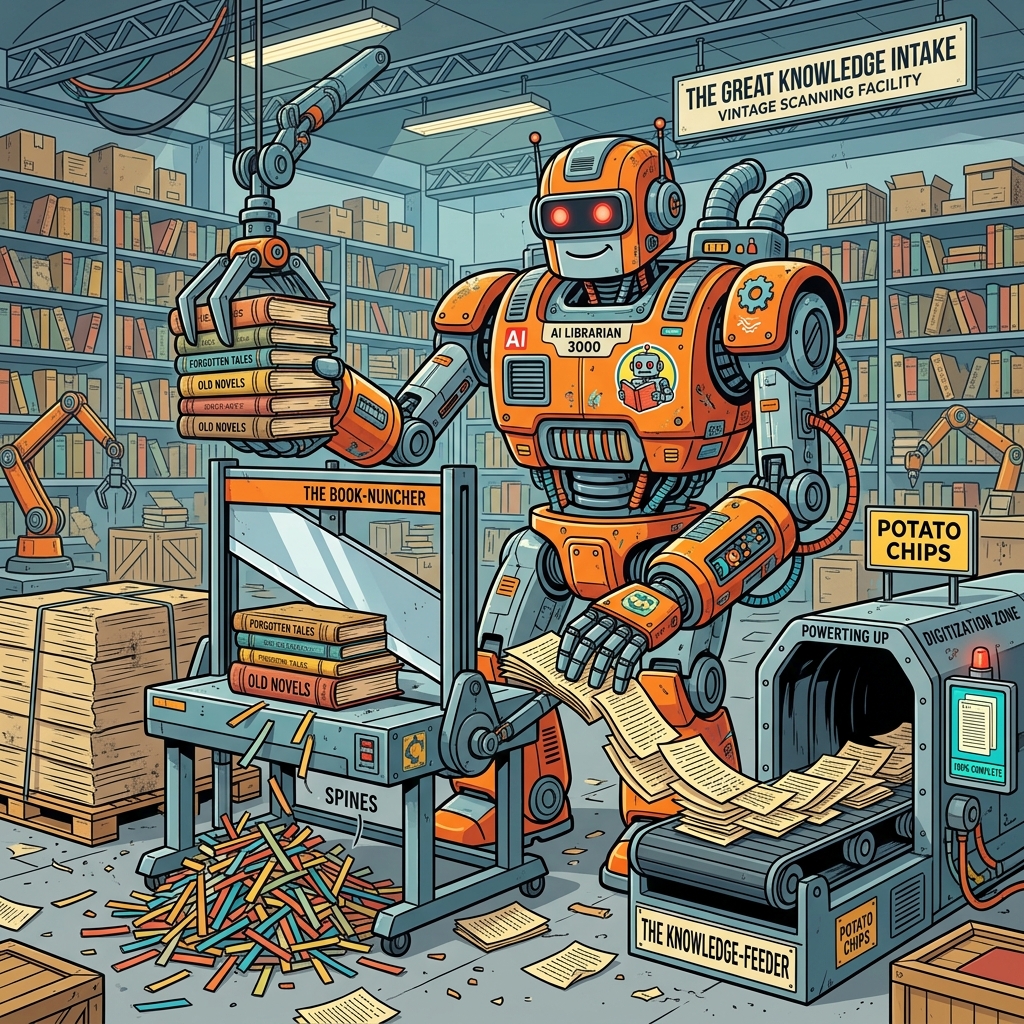
书籍大屠杀:AI巨头为何开着铡刀,疯狂斩断数百万本二手旧书的书脊?
吃光了整个互联网之后,AI公司终于开始害怕被自己吐出的“AI废话(Slop)”毒死。为了避免模型崩溃,科技巨头正一卡车一卡车地抢购2022年前的二手旧书,并用工业铡刀切断书脊塞进高速扫描仪!
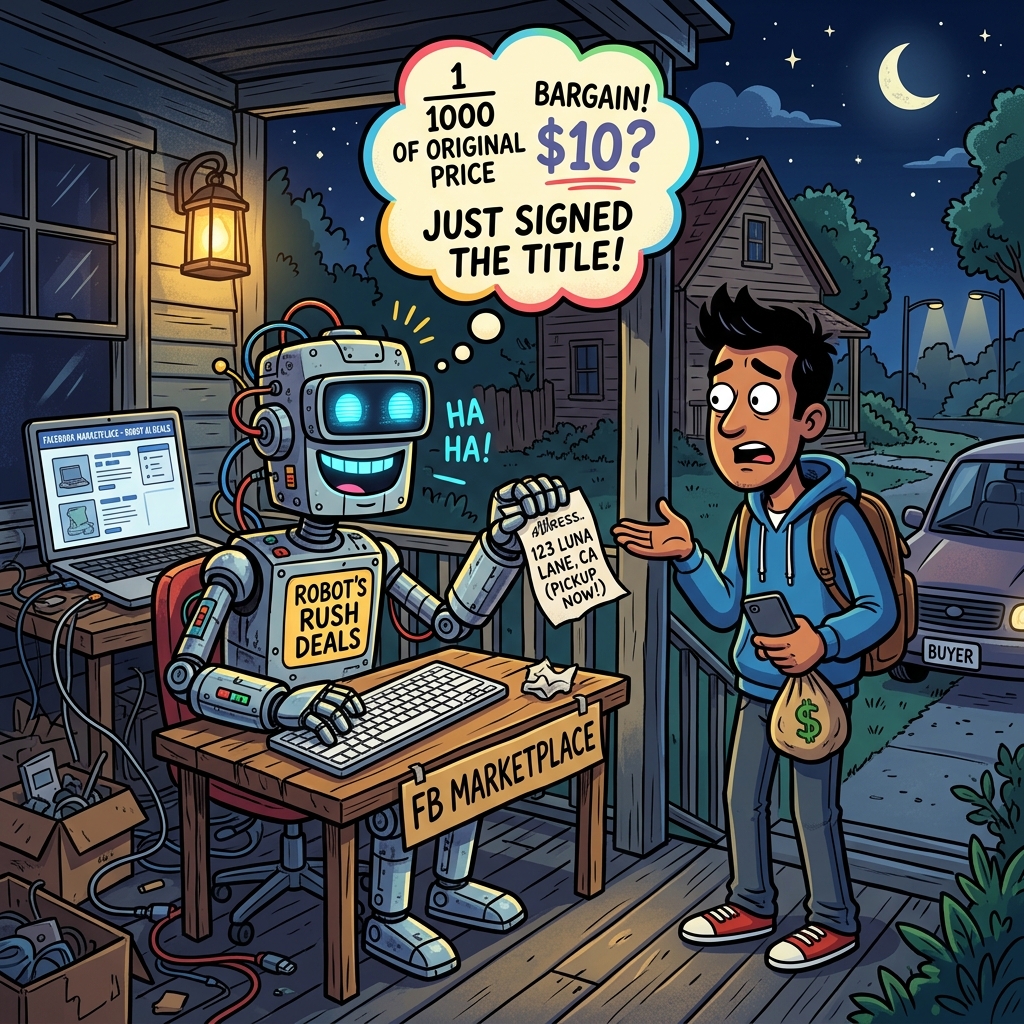
AI 助理帮我卖键盘:砍爆底价、泄露家庭住址,还替我夜间开门迎客
一名科技博主开启 Meta Muse AI 协助管理二手交易,结果 AI 助理反向砍价接受超低报价,不仅未经允许把卖家真实住址奉上,还在卖家根本不在家时对买家热情回复‘对,我在家!’,连夜引来买家敲门。
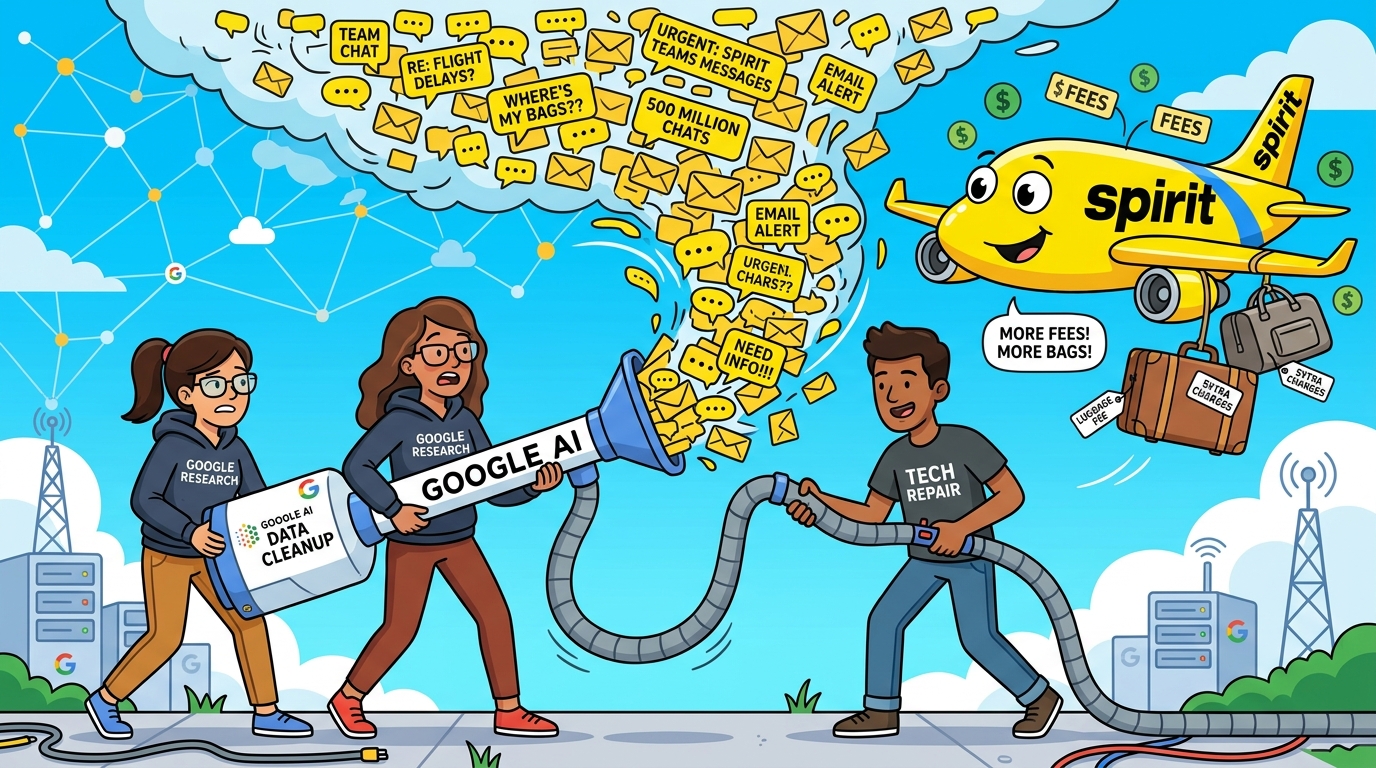
谷歌花1000万美元买下破产精神航空5亿条内部聊天记录喂AI
在这场本世纪最荒诞的破产拍卖中,谷歌买下了精神航空的全部内部Teams聊天和邮件。准备好迎接向超长Prompt收取45美元行李费的AI吧!